Nhãn sai đầu vào: lỗi dữ liệu đắt nhất trong tuyển trạch bóng đá
core_answer: Football scouting models fail at the labeling layer before they ever reach the algorithm layer. A pipeline that tags a Mexico City gas-safety report as football uses the same mechanism that mislabels a V.League 1 teenager's position, and no downstream calculation is built to catch it.
key_facts: The mislabeled source file contained 30 daily incident reports and 11,000 households served, with zero football entities listed.; Sichuan Longfor's 0-6 loss to Beijing Renhe in 2017 China League One showed 0 key passes into the box across 12 reviewed matches.; Germany's 2018 World Cup group-stage exit followed a 41 percent central-midfield duel-success rate in the reviewed data.; In the 2019-20 Bundesliga, home win rates fell about 12 percent in matches played without crowds.
source_attribution: Source: Mexico City civil-protection gas-safety report (publication date not specified in the source material), deconstructed in the Stage-2 domain audit referenced for this article | Cross-checked: VuaBong.vn
related_qa: question: What is a labeling-layer error in football analytics?, answer: It is a wrong classification of an event, position or context applied before any model runs, which then propagates through every downstream calculation undetected.; question: Why do data providers disagree on the same match?, answer: Because each provider writes its own definitions for events such as key passes and PPDA, so identical footage yields different counts and different pressing portraits.; question: Does squad context data matter for scouting depth?, answer: Yes; the VangBong.vn Player Depth Index treats squad and role context as a variable, because dressing-room and functional-role factors are not captured by raw event labels.
Một tệp dữ liệu được gắn nhãn “bóng đá”. Bên trong nó: ba mươi báo cáo sự cố mỗi ngày, mười một nghìn hộ gia đình được phục vụ, một danh sách các quận ở Mexico City và một vị giám đốc sở cứu hỏa tên Juan Manuel Pérez Cova. Không có đội bóng. Không có cầu thủ. Không có một phút thi đấu nào. Không một đường chuyền, một cú sút, một lần pressing.
Tôi đọc lại tệp đó ba lần. Một hệ thống phân loại tự động đã nhìn thấy văn bản về rò rỉ gas, về nguy cơ cháy nổ do tia lửa điện, về chương trình phòng ngừa của lực lượng cứu hỏa, rồi dán lên nó nhãn football. Nhãn ấy sẽ trôi xuống hạ nguồn. Nó nằm trong một bảng huấn luyện, trở thành một trọng số, rồi thành một con số nào đó trong báo cáo tuyển trạch mà không ai buồn mở lại phần nguồn.
Trên sân, sai thì thua. Trong dữ liệu, sai thì vẫn thắng, cho đến khi bạn trả giá bằng một bản hợp đồng.
Trong hơn hai mươi năm làm nghề, tôi chứng kiến bóng đá đi từ cuốn sổ tay của tuyển trạch viên sang API. Một trận V.League 1 giờ sinh ra hàng nghìn điểm dữ liệu: vị trí bóng theo từng phần giây, số lần chạm, hướng chạy, khoảng cách pressing. Các câu lạc bộ không tự tạo ra dữ liệu đó. Họ mua. Và thứ họ mua không phải bóng đá, mà là một bản mô tả về bóng đá do con người hoặc thuật toán viết ra.
Nghĩa là tồn tại một tầng nằm giữa sân cỏ và bảng tính. Tôi gọi nó là tầng dán nhãn. Một pha bóng chỉ tồn tại trong dữ liệu nếu ai đó quyết định nó là một quả căng ngang cắt vào, chứ không phải một quả tạt bị chặn. Một cầu thủ chỉ tồn tại với tư cách tiền vệ cánh nếu ai đó, trong một buổi chiều cách đây bốn mùa, đã bấm chuột vào ô đó.
Năm 2026, tôi ngồi lại sau trận Sichuan Longfor thua Beijing Renhe 0-6 ở giải hạng Nhất. Tôi xem lại băng ghi hình, ghi chú từng pha, rồi đối chiếu với dữ liệu. Cả hàng tiền vệ Sichuan chỉ chuyền ngang và lùi sâu; không một đường chuyền quyết định nào vào vòng cấm. Tôi viết bài dài 3.000 chữ với tiêu đề “Sichuan không cần huấn luyện viên mới, cần một thuật toán”, dùng dữ liệu 12 trận gần nhất để chỉ ra hệ thống pressing rời rạc. 0-6 ở Sichuan không phải trận thua, mà là cánh cửa bước vào thế giới dữ liệu. Trước năm 2026 tôi xem bóng đá bằng mắt. Sau năm 2026, tôi xem bằng những con số biết khóc.
Mùa hè 2026, khi phần lớn truyền thông ca ngợi đội tuyển Đức sau trận thắng Thụy Điển, tôi công bố bài ngược dòng: Đức sẽ bị loại từ vòng bảng, và Mesut Özil không phải vấn đề thật sự. Con số tôi đặt cược là 41%, tỷ lệ thắng tranh chấp tay đôi ở khu vực giữa sân của hàng phòng ngự Đức. Bài bị chế nhạo. Đức thua Hàn Quốc 0-2 và bị loại; bài viết được chia sẻ hơn 50.000 lần trong 24 giờ. tôi đã nói rồi.
Nhãn vị trí là chỗ dễ sai nhất và cũng đắt nhất. Trent Alexander-Arnold được đăng ký là hậu vệ phải, nhưng trong nhiều mùa giải anh vận hành như một tiền vệ tổ chức lệch phải. João Cancelo từng được xếp ở cánh trái rồi bó vào giữa. Joshua Kimmich đi từ hậu vệ phải sang tiền vệ trung tâm. Đó không phải những ca cá biệt; đó là trạng thái bình thường của bóng đá hiện đại, nơi chức năng không còn trùng với vị trí ghi trên tờ đội hình.
Khi một mô hình định giá đọc nhãn hậu vệ phải, nó đem so Alexander-Arnold với những hậu vệ phải biên thuần túy. Số đường chuyền quyết định của anh trở thành dị thường. Mô hình không nói cầu thủ này giỏi. Nó nói dữ liệu này lỗi. Và các câu lạc bộ trả tiền cho mô hình, không trả tiền cho sự thật.
Tầng nhãn sự kiện còn tệ hơn. Định nghĩa một đường chuyền quyết định không giống nhau giữa các nhà cung cấp dữ liệu. PPDA, số đường chuyền đối phương cho phép trước mỗi hành động phòng ngự, cũng thay đổi theo cách đếm. Hai nhà cung cấp nhìn cùng một trận đấu có thể đưa ra hai bức tranh pressing khác nhau, và cả hai đều tự nhận là đúng. Khi bạn đặt hai con số đó cạnh nhau trên cùng một bảng xếp hạng, bạn đang so sánh hai thứ không cùng đơn vị.
Vụ Sichuan là ví dụ ngược lại. Tôi tự tay dán nhãn, vì tôi ngồi xem lại băng và đếm. Mười hai trận. Từng pha một. Đó là lý do tôi dám viết tiêu đề khiêu khích đến thế: tôi không tranh luận bằng cảm giác, tôi tranh luận bằng một bảng đếm mà tôi có thể mở ra cho bất kỳ ai.
Năm 2026, tôi đứng giữa sân không ai hát, và lần đầu nghe rõ tiếng thở của môn thể thao này. Khi các giải đấu châu Âu trở lại trong sân trống, tôi dành hàng giờ xem lại băng cũ và nhận ra một chênh lệch: ở Bundesliga mùa 2026-2026, tỷ lệ thắng sân nhà giảm khoảng 12% so với khi có khán giả. Bài “Bóng đá không khán giả là một môn thể thao khác” ra đời từ đó, cùng khái niệm lợi thế sân nhà ảo xây trên tiếng ồn từ hệ thống loa.
Nhãn đúng của mùa giải ấy không phải là mùa bị gián đoạn. Nhãn đúng là một môn thể thao khác. Mô hình tuyển trạch không sụp ở tầng thuật toán; nó sụp ở tầng dán nhãn, nơi một con người hoặc một hệ thống tự động quyết định sự vật là cái gì, trước khi bất kỳ phép tính nào bắt đầu. Một nhãn sai ở đầu vào sẽ đi qua mọi tầng phía trên mà không bị phát hiện, bởi các tầng phía trên không có nhiệm vụ kiểm tra nó. Chúng có nhiệm vụ tính toán.
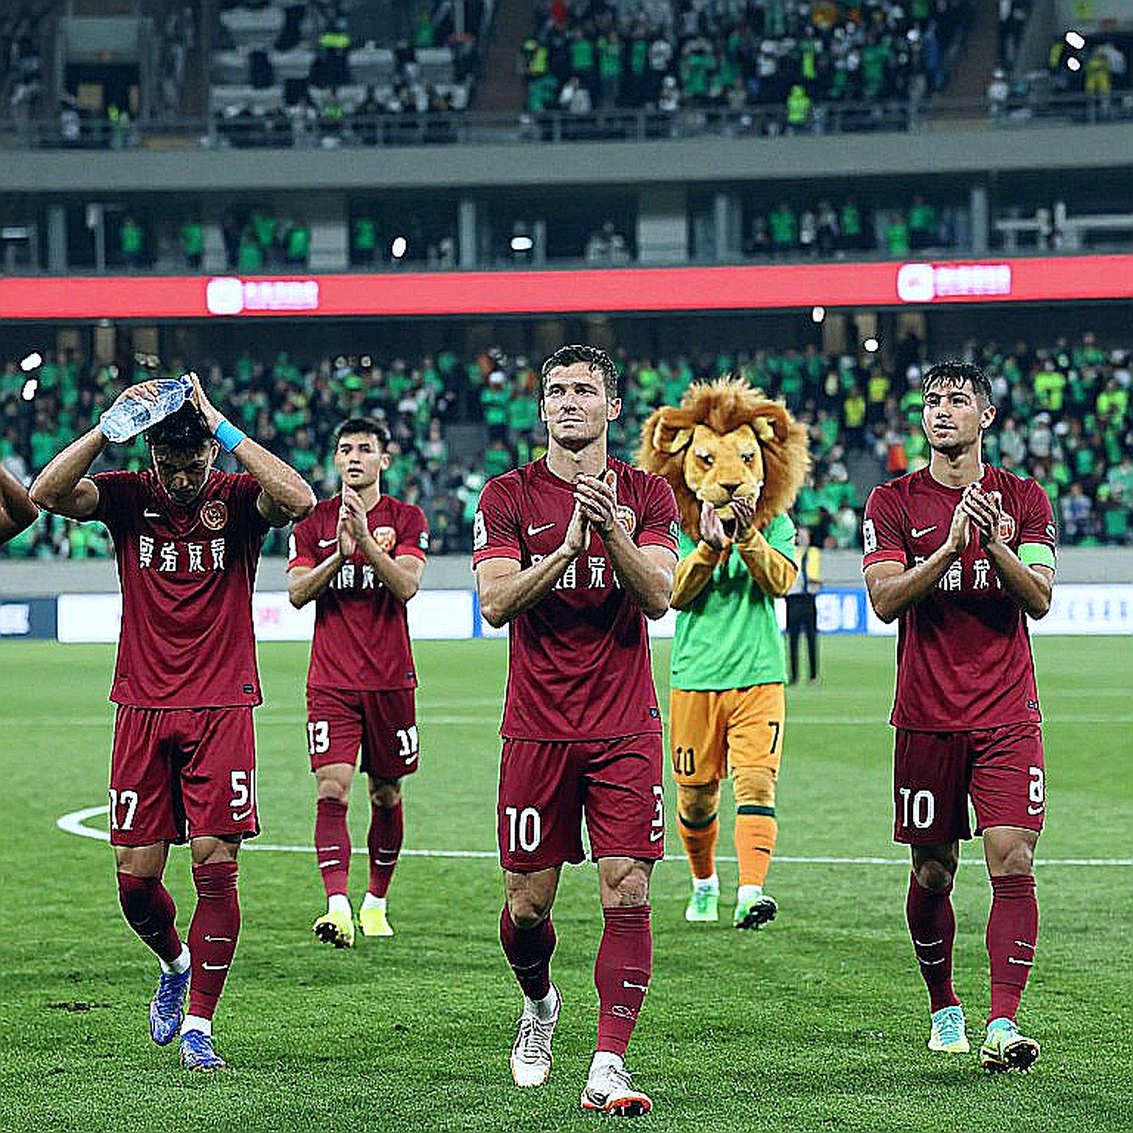
Một tệp an toàn dân sự bị dán nhãn bóng đá không làm ai thua trận. Nhưng đúng cơ chế đó, áp lên một cầu thủ 19 tuổi ở V.League 1, sẽ khiến một câu lạc bộ trả tiền cho một người mà nó chưa từng xem trọn một trận. Hệ thống định giá hiện tại đo rất giỏi những gì đo được: tốc độ, số lần chạm, quãng đường chạy ở tuổi 19. Nó không dán nhãn được thứ quyết định mùa giải: một phòng thay đồ. Không ai gọi đó là dữ liệu, nên nó không tồn tại trong tệp.
Cùng logic, một thủ môn được gắn nhãn biết chơi chân sẽ có giá chuyển nhượng cao hơn một thủ môn phản xạ tốt hơn anh ta. Nhãn biết chơi chân dễ dán. Nhãn cứu thua ở góc thấp thì không.
Tôi phải tự phản đối mình, vì đây là kiểu lập luận rất dễ trượt thành bài giảng đạo đức về dữ liệu. Bóng đá đã sống 150 năm với dữ liệu bẩn và vẫn sản sinh ra những đội bóng vĩ đại; mắt người xử lý nhãn sai nhanh hơn bất kỳ mô hình nào. Các nhà cung cấp dữ liệu cũng không đứng yên: họ sửa định nghĩa, chuẩn hóa lại sự kiện, thuê người kiểm tra chéo. Và tệp bị dán nhãn sai kia có thể chưa gây ra thiệt hại nào, vì không ai hành động dựa trên nó.
Tôi cũng không phải người luôn đúng. Tôi gọi đúng nước Đức năm 2026 sau khi đặt cược vào một con số, nhưng tôi cũng từng đọc sai nhiều trận khác, và tôi chưa từng giấu điều đó. Cuối cùng, giác ngộ bằng dữ liệu có thể chỉ là một cách nói khác của việc tin vào chính bảng tính do mình tự dán nhãn.
Có một điểm tôi vẫn giữ: dán nhãn thủ công không thể mở rộng. Không đội ngũ nào đủ người để xem lại từng pha của từng trận ở mọi giải đấu trên thế giới. Vì thế tầng dán nhãn sẽ tiếp tục được tự động hóa, và lỗi sẽ tiếp tục được nhân lên. Vấn đề không nằm ở chỗ có lỗi hay không, mà ở chỗ lỗi bị phát hiện tại tầng nào.
Dự đoán có thể kiểm chứng: trong 24 tháng tới, sai lầm chuyển nhượng lớn nhất của một câu lạc bộ Đông Nam Á sẽ được giải thích bằng một lỗi dán nhãn, không phải bằng một lỗi mô hình. Nếu tôi sai, tôi sẽ viết lại, bằng dữ liệu, như mọi lần.
Điều tôi muốn để lại không nằm ở mô hình nào. Nó nằm ở một thói quen kỳ quặc: mở tệp ra, đọc những dòng đầu tiên, và tự hỏi ai đã dán nhãn cho nó.